Hay algunos que quizás abran las ojos "como dos de oro" por ésta pregunta, pero no es la primera vez que la leo ni que me la hacen, así que vá la respuesta:
Si instalás todos los DVDs/CDs de Debian, vas a tener mucho espacio en disco rígido ocupado. Muy posiblemente, de gusto.
Tener todos los discos a mano sirve si no tenés una buena conexión a internet. Con eso sabés que la gran mayoría de las cosas las tenés disponibles en cualquier momento. Pero no instales todo, solo lo que vos necesites, aunque solo sea del primer medio. Dejá que apt se haga cargo del resto :-)
Si tenés un contraejemplo... sabés lo que estás haciendo y no necesitás que te lo explique =)
miércoles, 18 de enero de 2012


lunes, 21 de noviembre de 2011
Seguimos moviendo partículas, ésta vez con OpenCL
Y ahora le toca el turno al segundo trabajo práctico de HPC@UNS. Ésta vez vamos a seguir moviendo partículas, pero con mayor grado de paralelización, ya que vamos a usar OpenCL sobre una placa nVidia GeForce 8800 GTS 512 (rev a2) y Debian.
Por si solo no nos dice mas que el algoritmo tiene una dependencia O(n²) con el número de partículas. Ésto es natural ya que se trata del mismo código serial que en el práctico anterior, ésta vez convertido a OpenCL.
Nota: el código original está bajo la licencia BSD modificada (¡Gracias Vasily Volkov!). El código modificado mantiene la licencia.
Como en el caso del práctico anterior, se pueden tomar otras estrategias para reducir el orden de complejidad del código... pero no es lo que nos intereza ahora. La idea es comparar estos resultados con los ya obtenidos. Pero antes...
Nota importante: el código de OpenCL utiliza floats en vez de doubles para los cálculos. Ésto es debido a que la placa gráfica no soporta éste último tipo. Ésto llevó a la necesidad de aumentar la masa de la partícula, ya que el valor original producía errores numéricos que producían que las partículas se aceleraran.

Lo primero que podemos observar es que el tiempo de cálculo requerido para un número de partículas menor a ~[64 128] (según la implementación y el host) es menor para el caso serial que para el caso con OpenCL. Ésto era de esperarse, ya que se consume un tiempo importante en pasar datos hacia y desde la placa de video al host. Es decir, vale la pena implementar éstas soluciones si el número de datos a procesar es grande.

Es interesante notar como OpenMP sobre Luna (AMD Athlon (tm) 64 X2 Dual core processor 5000+) presenta mejor tiempo de cálculo que OpenCL para menos de 1024 partículas. A su vez, la implementación de OpenMP en cardumen (UltraSparc T2 (Niagara2)) es mas lenta. A medida que el volumen de datos aumenta, OpenCL comienza a ser mas eficiente.

Las comparaciones para PThreads son bastante similares a las anteriores. Tarea para el lector :-)
Notas y conclusiones
 |
| Cada punto del gráfico es el promedio de 5 corridas del mismo algoritmo con los mismos parámetros. |
Nota: el código original está bajo la licencia BSD modificada (¡Gracias Vasily Volkov!). El código modificado mantiene la licencia.
Como en el caso del práctico anterior, se pueden tomar otras estrategias para reducir el orden de complejidad del código... pero no es lo que nos intereza ahora. La idea es comparar estos resultados con los ya obtenidos. Pero antes...
Nota importante: el código de OpenCL utiliza floats en vez de doubles para los cálculos. Ésto es debido a que la placa gráfica no soporta éste último tipo. Ésto llevó a la necesidad de aumentar la masa de la partícula, ya que el valor original producía errores numéricos que producían que las partículas se aceleraran.
Lo primero que podemos observar es que el tiempo de cálculo requerido para un número de partículas menor a ~[64 128] (según la implementación y el host) es menor para el caso serial que para el caso con OpenCL. Ésto era de esperarse, ya que se consume un tiempo importante en pasar datos hacia y desde la placa de video al host. Es decir, vale la pena implementar éstas soluciones si el número de datos a procesar es grande.
Es interesante notar como OpenMP sobre Luna (AMD Athlon (tm) 64 X2 Dual core processor 5000+) presenta mejor tiempo de cálculo que OpenCL para menos de 1024 partículas. A su vez, la implementación de OpenMP en cardumen (UltraSparc T2 (Niagara2)) es mas lenta. A medida que el volumen de datos aumenta, OpenCL comienza a ser mas eficiente.
Las comparaciones para PThreads son bastante similares a las anteriores. Tarea para el lector :-)
Notas y conclusiones
- OpenCL tiene muy buen desempeño para volumenes de datos grandes, aunque vale la salvedad de que se utilizaron floats en vez de doubles. Quizás si algún dia pongo mis manos en una placa con soporte para doubles pruebe a ver que pasa.
- OpenCL es un estándar, pero sólo provee los headers (API). Las implementaciones dependen de cada fabricantes, y no son software libre, al menos por ahora. Ésto atenta contra la portabilidad del código.
- QtOpenCL está genial :-)
martes, 18 de octubre de 2011
Moviendo partículas y binarizando imágenes
Como parte de la entrega del trabajo práctico Nº 1 de la materia HPC@UNS era requerido hacer una página web con los resultados. Me pareció mas práctico usar mi blog... y acá estamos.
Partículas en movimiento
La primera parte del TP era ir a un sitio de Berkeley y bajar el código para simular la interacción entre partículas usando un algoritmo totalmente serial, otro utilizando PThreads y otro OpenMP. Lo primero que hice fué hacer unas corridas y ver los resultados que obtenía.
Nota: cada punto del gráfico es el promedio de 5 corridas del mismo algoritmo con los mismos parámetros. -Esto es válido para todos los gráficos de éste blog post, pero en los datos usados para generar los primeros solo se encuentran los valores ya promediadios.
Notemos que el número de threads de OpenMP no está definido, sino que se toma el de la instalación por defecto (Debian Wheezy en ambas máquinas).
Enseguida podemos notar varias cosas:
Nota: debido a que el código fuente original no estipula una licencia y por ende se debe interpretar como "todos los derechos reservados", no hago públicas las modificaciones del código.
Actualización 18/11/2011: le escribí a Vasily Volkov, responsable del sitio y código de Berkeley arriba linkeado, y tuvo la gentileza de reponderme diciéndome que la licencia en BSD modificada. En el repositorio del código incluyo el mail (en formato mbox) y la licencia propiamente dicha. ¡Gracias Vasily!
En éste caso vemos que tanto para Cardumen (Sparc) como para Luna (AMD Athlon) los cambios generaron una reducción del tiempo de ejecución. A su vez, podemos comparar el desempeño de ambos procesadores.
En el caso de OpenMP resalta claramente como influye utilizar una excesiva cantidad de hilos en Cardumen para muy pocos datos. Notar que lso tiempos tienden a ser levemente menores para mas de ~4000 partículas.
Partículas en movimiento
La primera parte del TP era ir a un sitio de Berkeley y bajar el código para simular la interacción entre partículas usando un algoritmo totalmente serial, otro utilizando PThreads y otro OpenMP. Lo primero que hice fué hacer unas corridas y ver los resultados que obtenía.
Nota: cada punto del gráfico es el promedio de 5 corridas del mismo algoritmo con los mismos parámetros. -Esto es válido para todos los gráficos de éste blog post, pero en los datos usados para generar los primeros solo se encuentran los valores ya promediadios.
 |
| Respuesta en tiempo al número de partículas de cada implementación en un servidor Sparc T2 (Niágara2) de 8 cores con 8 hilos livianos cad uno. |
 |
| Respuesta en tiempo al número de partículas de cada implementación en una máquina AMD Athlon 64 X2 Dual Core processor 5000+. |
Notemos que el número de threads de OpenMP no está definido, sino que se toma el de la instalación por defecto (Debian Wheezy en ambas máquinas).
Enseguida podemos notar varias cosas:
- Los algoritmos son O(n²). Nada raro si uno mira el código fuente, los ciclos for anidados saltan a la vista.
- Paralelizar el algoritmo vale la pena a partir de una cierta cantidad de datos. Se podría pensar en ~256 como un buen número de threshold, aunque seguramente es dependiente del hardware y del problema/implementación del algoritmo.
- Crear hilos tiene un costo mínimo asociado. En el caso del Sparc, el costo es mayor, aunque es notable como mejora el rendimiento con OpenMP.
Intentemos mejorar éste desempeño.
Mirando el código fuente vemos que la interacción entre partículas se calcula todas entre todas. Lo interesante es que el resultado de la interacción de una partícula p con una partícula q es la misma pero de signo contrario a la interacción de la partícula q con la partícula p. Entonces podemos hacer los cálculos una sola vez entre dos partículas cualquiera.
Mirando el código fuente vemos que la interacción entre partículas se calcula todas entre todas. Lo interesante es que el resultado de la interacción de una partícula p con una partícula q es la misma pero de signo contrario a la interacción de la partícula q con la partícula p. Entonces podemos hacer los cálculos una sola vez entre dos partículas cualquiera.
Por otro lado, la interacción entre partículas es basada en la distancia entre ellas. Si la distancia es cero, no hay interacción. Entonces una partícula no interactúa con si misma.
Desde el punto de vista del hardware y el paralelismo, podemos utilizar la máxima cantidad e hilos posibles para cada caso. Definitivamente ésto va a traer acarreado mayor tiempo de ejecución en los casos de pocas partículas, pero debería ser mejor a medida que el número de partículas aumenta.
Actualización 18/11/2011: le escribí a Vasily Volkov, responsable del sitio y código de Berkeley arriba linkeado, y tuvo la gentileza de reponderme diciéndome que la licencia en BSD modificada. En el repositorio del código incluyo el mail (en formato mbox) y la licencia propiamente dicha. ¡Gracias Vasily!
Veamos entonces los resultados, empezando por el caso serial.
 |
| Comparación del algoritmo original (1.0.1) con el algoritmo modificado 1.1.6 para el caso serial. |
En éste caso vemos que tanto para Cardumen (Sparc) como para Luna (AMD Athlon) los cambios generaron una reducción del tiempo de ejecución. A su vez, podemos comparar el desempeño de ambos procesadores.
 |
| Comparación del algoritmo original (1.0.1) con el algoritmo modificado 1.1.6 para el caso con OpenMP. |
 |
| Comparación del algoritmo original (1.0.1) con el algoritmo modificado 1.1.6 para el caso con PThreads. |
Aquí también se puede observar el costo que tiene utilizar muchos threads con pocos datos. En éste caso se hace notoria la mejora de rendimiento entre las dos versiones de PThreads en Cardumen.
No puede faltar un gráfico con todos los resultados:
No puede faltar un gráfico con todos los resultados:
 |
| Todos los resultados juntos. |
¿Podemos mejorar aún mas el algoritmo?
Si, y (teóricamente) mucho. El "truco" está en reducir la complejidad del algoritmo lo mas posible. Para eso hay que detectar el cuello de botella, que no es otro que el cálculo de las fuerzas entre cada partícula. Dijimos que la interacción entre las mismas es una relación de la distancia. Pero lo que no nombramos es que, luego de una cierta distancia r, ya no interactúan entre ellas. Debemos entonces encontrar una forma de que cada partícula solo calcule la fuerza que podrían llegar a ofrecerles posibles partículas aledañas.
Una posible solución sería dividir el espacio bidimensional en una matriz donde cada casillero sea de tamaño rxr. Cada vez que se mueve una partícula se la ubica en el casillero correspondiente a su zona final. Luego basta considerar sólo las fuerzas que aplican las partículas en el mismo casillero y en los casilleros aledaños. Si bien suena sencillo, se hace necesario sincronizar el acceso a cada partícula entre los hilos y sus propiedades.
Yo no llegué a implementarlo, pero MorningCoffee si lo ha hecho. Lamentablemente tampoco lo llegué a probar :-(
Haciendo trabajar a Cardumen
Ahora la idea no es analizar el algoritmo sino como responde el servidor con ése algoritmo ante distintas cargas y números de threads.

En el caso de OpenMP podemos ver como se va incrementando el costo fijo de generar una cantidad determinada de threads. Podemos ver que, para muy pocas partículas (hasta ~20), tener un solo hilo de OpenMP (que debería ser el mismo caso que el algoritmo totalmente serial) tiene un overhead.
También se puede observar que dada una cierta cantidad de partículas realmente vale la pena usar paralelización.

El mismo análisis se puede hacer para PThreads.

Y, por supuesto, podemos ver todos los resultados juntos. Las referencias corresponden a la simulación serial, luego las de OpenMP terminando con las de PThreads.
Veamos ahora el speedup de cada caso:

Puede verse que la performance de PThreads es similar.

Resulta posible observar que en ambos casos el speedup se aproxima al teórico para cada número de threads.
¿Y que pasaría si tuviésemos una cantidad fija de threads para utilizar?

¿Tenés los resultados a mano?
Si, pueden obtenerlos acá.
Binarizando imágenes
La idea de la segunda parte del TP es binarizar dos juegos de 100 imágenes de 360 y 1080 pixeles cada uno. Primero resolver el problema de forma serial y luego paralelizarlo. Visto gráficamente, la idea es pasar de una imagen como:
A una imagen con solo dos tonos:
Para lograr ésto usé Qt. no lo hice la manera mas eficiente, ya que utilicé QImage::pixel() y QImage::setPixel(). Podría haber utilizado los métodos de QImage para acceder a los pixeles como vecotres de datos. Pero bueno, para el propósito de éste TP, alcanza. Aproveché el envión que llevo de aprender CMake y lo usé para compilar. Se los recomiendo. El código fuente lo pueden encontrar acá.
La estrategia
Tan sencilla como hacer que cada hilo se ocupe de procesar una imagen. No hay interdependencia entre ellas, por lo que no es necesario sincronizar los threads. Dicho de otra manera, no hay necesidad de procesar las imágenes en ningún orden en particular.
Los gráficos obtenidos
Podemos ver el tiempo de ejecución vs. el número de threads:

Es interesante ver la meseta que se forma entre los ~8 y ~20 threads.

En éste caso, la meseta no aparece.
Y también podemos medir el speedup. En amarillo, el speedup teórico ideal.
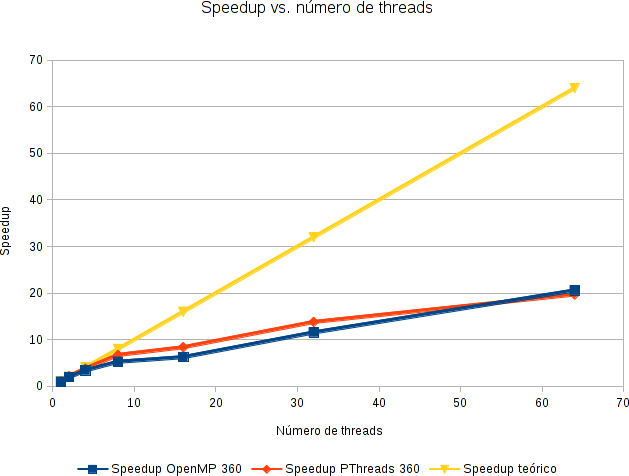

Realmente me sorpendió lo bajo del speedup :-/
Como nota al margen, Cardumen empezó a dar "Bus error" al momento de correr los algoritmos (entre ejecución y ejecución). Es posible que haya un problema de hardware en el mismo.
¿Y los resultados?
También están disponibles acá.
Algunas conclusiones
Si, y (teóricamente) mucho. El "truco" está en reducir la complejidad del algoritmo lo mas posible. Para eso hay que detectar el cuello de botella, que no es otro que el cálculo de las fuerzas entre cada partícula. Dijimos que la interacción entre las mismas es una relación de la distancia. Pero lo que no nombramos es que, luego de una cierta distancia r, ya no interactúan entre ellas. Debemos entonces encontrar una forma de que cada partícula solo calcule la fuerza que podrían llegar a ofrecerles posibles partículas aledañas.
Una posible solución sería dividir el espacio bidimensional en una matriz donde cada casillero sea de tamaño rxr. Cada vez que se mueve una partícula se la ubica en el casillero correspondiente a su zona final. Luego basta considerar sólo las fuerzas que aplican las partículas en el mismo casillero y en los casilleros aledaños. Si bien suena sencillo, se hace necesario sincronizar el acceso a cada partícula entre los hilos y sus propiedades.
Yo no llegué a implementarlo, pero MorningCoffee si lo ha hecho. Lamentablemente tampoco lo llegué a probar :-(
Haciendo trabajar a Cardumen
Ahora la idea no es analizar el algoritmo sino como responde el servidor con ése algoritmo ante distintas cargas y números de threads.
En el caso de OpenMP podemos ver como se va incrementando el costo fijo de generar una cantidad determinada de threads. Podemos ver que, para muy pocas partículas (hasta ~20), tener un solo hilo de OpenMP (que debería ser el mismo caso que el algoritmo totalmente serial) tiene un overhead.
También se puede observar que dada una cierta cantidad de partículas realmente vale la pena usar paralelización.
El mismo análisis se puede hacer para PThreads.
Y, por supuesto, podemos ver todos los resultados juntos. Las referencias corresponden a la simulación serial, luego las de OpenMP terminando con las de PThreads.
Veamos ahora el speedup de cada caso:
Puede verse que la performance de PThreads es similar.
Resulta posible observar que en ambos casos el speedup se aproxima al teórico para cada número de threads.
¿Y que pasaría si tuviésemos una cantidad fija de threads para utilizar?
¿Tenés los resultados a mano?
Si, pueden obtenerlos acá.
Binarizando imágenes
La idea de la segunda parte del TP es binarizar dos juegos de 100 imágenes de 360 y 1080 pixeles cada uno. Primero resolver el problema de forma serial y luego paralelizarlo. Visto gráficamente, la idea es pasar de una imagen como:
 |
| (c) copyright 2008, Blender Foundation / www.bigbuckbunny.org. Bajo licencia CC-BY 3.0. |
A una imagen con solo dos tonos:
 |
| (c) copyright 2008, Blender Foundation / www.bigbuckbunny.org. Bajo licencia CC-BY 3.0. Modificado por mi código :-) |
La estrategia
Tan sencilla como hacer que cada hilo se ocupe de procesar una imagen. No hay interdependencia entre ellas, por lo que no es necesario sincronizar los threads. Dicho de otra manera, no hay necesidad de procesar las imágenes en ningún orden en particular.
Los gráficos obtenidos
Podemos ver el tiempo de ejecución vs. el número de threads:
Es interesante ver la meseta que se forma entre los ~8 y ~20 threads.
En éste caso, la meseta no aparece.
Y también podemos medir el speedup. En amarillo, el speedup teórico ideal.
Realmente me sorpendió lo bajo del speedup :-/
Como nota al margen, Cardumen empezó a dar "Bus error" al momento de correr los algoritmos (entre ejecución y ejecución). Es posible que haya un problema de hardware en el mismo.
¿Y los resultados?
También están disponibles acá.
Algunas conclusiones
- OpenMP hace la vida de un programador mucho mas sencilla que PThreads por poca o nada de diferencia en tiempo de ejecución.
- Esperaba que el Sparc tuviese un mejor rendimiento. Mi sospecha es que no se trata de un servidor diseñado para procesar datos de punto flotante (posee una sola FPU por core, es decir, una FPU por cada 8 hilos).
- Estaría bueno poder decirle a OpenMP/Sistema Operativo que ponga un hilo por core. hasta donde sé, pueden crearse 8 hilos pero no hay ninguna garantía de que cada uno corra en un core. Ésto serviría para reducir el tiempo en cálculos con mucho uso de FPU.
domingo, 25 de septiembre de 2011
Desarrollador de Debian
Ésta madrugada recibí el mail que confirma la creación de mi cuenta en los servidores de Debian. En otras palabras ¡soy DD! Tengo una alegría enorme :)
Por supuesto, no llegué hasta acá sin el invalorable esfuerzo de otras personas. Mi seguramente incompleta lista de agradecimientos va a (en orden cronológico) Marga Manterola y la muchachada entera del LugFI, Ana Guerrero, el equipo Qt-KDE, Hauke Rahm que fué mi AM, Telma, mi novia, que me conoció y aceptó como debianita con todo lo que eso implica y a un montón de gente mas que me acompaña desde hace años.
A todos ustedes muchas gracias. Espero poder seguir siendo útil en la tarea de lograr el mejor Sistema Operativo Universal.
jueves, 4 de agosto de 2011
A veces a uno le falta teoría...
Antes que nada, no tengo formación teórica-pura de Programación Orientada a Objetos (POO). Lo que sé lo aprendí de libros varios que apuntan a enseñar programación orientada a objetos para un cierto lenguaje. Y tampoco tengo un conocimiento de compiladores+assembler lo suficiente bueno como para no estar preguntandome ésto. El lado bueno: al menos se me ocurre pensarlo :-)
Veamos éste caso:
Si, justo lo que no debiese hacerse en POO. Pero suponiendo que ya instancié un objeto con ésta clase y éste tuviese un valor, podría accederlo como:
Desde el punto de vista de acceso, debería ser inmediato. Si ahora usamos:
Para obtener el valor de foo haríamos:
Lo que puede llegar a implicar que el compilador genere código para entrar en el método foo(), haciendo mas lento el acceso al valor.
Ahora, en éste otro caso:
Un acceso quizás sea tan rápido como en el primero, ya que se me ocurre que el compilador tenga el hint del inline para mejorar el acceso.
Seguramente me estoy perdiendo *mucho* a causa de mi ignorancia. Pero les cuento a que vino todo ésto: se me ocurrió pensar que pasaría si existiese una propiedad de visivilidad que permita que cualquiera acceda al valor de la propiedad de la clase para lectura, pero sólo la clase pueda modificar dicho valor. ¿sería mas "sencillo" programar?
En fin, nada mas mostrándole al mundo mis dudas e ignorancia :-)
Veamos éste caso:
class PublicFoo {
public:
  int mFoo;
}
Si, justo lo que no debiese hacerse en POO. Pero suponiendo que ya instancié un objeto con ésta clase y éste tuviese un valor, podría accederlo como:
PublicFoo data = new PublicFoo();
// De alguna manera se carga un dato...
int valor = data.mFoo;
Desde el punto de vista de acceso, debería ser inmediato. Si ahora usamos:
class PrivateFoo {
public:
  int foo() { return mFoo; };
  void setFoo(int foo) { mFoo = foo; };
private:
  int mFoo
}
Para obtener el valor de foo haríamos:
PrivateFoo data = new PrivateFoo();
// De alguna manera se carga un dato...
int valor = data.foo();
Lo que puede llegar a implicar que el compilador genere código para entrar en el método foo(), haciendo mas lento el acceso al valor.
Ahora, en éste otro caso:
class PrivateInlineFoo {
public:
  inline int foo() { return mFoo; };
private:
  int mFoo
}
Un acceso quizás sea tan rápido como en el primero, ya que se me ocurre que el compilador tenga el hint del inline para mejorar el acceso.
Seguramente me estoy perdiendo *mucho* a causa de mi ignorancia. Pero les cuento a que vino todo ésto: se me ocurrió pensar que pasaría si existiese una propiedad de visivilidad que permita que cualquiera acceda al valor de la propiedad de la clase para lectura, pero sólo la clase pueda modificar dicho valor. ¿sería mas "sencillo" programar?
En fin, nada mas mostrándole al mundo mis dudas e ignorancia :-)
domingo, 3 de julio de 2011
Una mandarina en Debian

El trabajo necesario para empaquetarlo fué mucho, y por eso agradezco a Thomas Pierson por eso :-)
Sugiero que no dejen de probarlo. Sabe mejor con una mandarina en mano ;-)
La imagen fué tomada de la Wikipedia.
viernes, 1 de julio de 2011
Carta abierta al presidente de CoNEAU
Bahía Blanca/Internet, 1º de Julio de 2011
Sr. Presidente de CoNEAU:
Tengo el gusto de dirigirme a Ud. para hacerle llegar mis inquietudes con respecto al software necesario para realizar las acreditaciones en las universidades nacionales de nuestro país.
Permitame primero comentarle acerca de mi situación actual: yo fuí empleado de la Universidad Nacional del Sur hasta el 31 de Diciembre de 2011. Hace unos pocos dias unos ex compañeros de trabajo me pidieron si no podía colaborar llenando la "ficha docente". Mas allá de que no estoy obligado a hacerla debido a que no soy mas un agente de dicha universidad, soy Argentino y creo que colaborar es una de las actividades que nos engrandece como pueblo y nación.
Para tal actividad se requiere del uso de un software (lo cuál encuentro totalmente entendible). Lamentablemente dicho software sólo corre bajo el sistema operativo Windows de Microsoft. Como presidente de la comisión encargada de evaluar pares seguramente estará al tanto de que no todo el sistema académico ni privado (como es mi posición actual) usa esa plataforma. Mi caso particular es ése: yo soy usuario de GNU/Linux [0], software libre[1], legal y gratuito. Comprar una licencia de Windows, además de costoso, va contra mi libertad de saber que es lo que mi máquina está haciendo. Y usted sabe que una buena formación académica lleva a que uno pueda saber como funcionan las cosas, mucho mas aún en mi caso particular de Ingeniero Electrónico y el software que corro.
Resultado: me veo imposibilitado de ayudar a mi universidad a cumplir con vuestros requisitos.
Por supuesto, puedo entender que el desarrollo de un software tiene un costo. Pero permítame decirle que el costo de desarrollar un software multiplataforma es, hoy por hoy, el mismo que desarrollar un software atado a una sola plataforma. De hecho, si se tiene en cuenta los beneficios de realizarlo como multiplataforma, la inversión resulta ser mas redituable en términos de uso.
Aún mas, los costos de obtener una plataforma de desarrollo para dicho software se reduce a una conexión a Internet: existen bibliotecas de alto nivel y calidad sin costo alguno, como por ejemplo el caso de Qt [2], por nombrar solo una.
Finalmente, permitame ir un paso mas allá y proponerle que la implementación de dicho programa sea también software libre. Si mal no tengo entendido, la CoNEAU se trata de una evaluación de pares. Como tal, las herramientas utilizadas a tal efecto no son lo importante, sino la información que ellas manejan. La posibilidad de que los distintos pares sean capaces de evaluar y mejorar la herramienta, sin perjuicio de los datos que ella maneje, contribuye a la mejora de la misma y a la credibilidad en el sistema.
Atte.,
Lisandro Damián Nicanor Pérez Meyer
DNI 29508104
Suscribirse a:
Entradas (Atom)

